AI 讀得懂全世界,卻讀不懂你的企業
圖 1
一、問題的起點:讀得懂語言,讀不懂數據庫
/朝聞通/通用大模型在通用任務上的表現已相當成熟:陌生領域的知識問答、行程規劃、散亂材料的梳理歸納,都能給出結構完整的輸出。這也是目前 AI 給人的普遍體感——全天在線,覆蓋面廣。
但換一類問題就不一樣了:“上個月銷量為什麼下滑?”
這類問題,大模型答不了。答案不在它的知識範圍裡,而在企業的 ERP 裡。
大模型的全稱是“大語言模型”,訓練語料是人類語言。隻要是人的表達,邏輯再複雜它都能理解;但數據庫不是為閱讀而設計的。以一套典型的零售 ERP 為例,系統内有 3.700 多張表。Excel 中名為“貨号”“銷量”“金額”的列,在數據庫裡對應的是 QTY,甚至是 XL——同一個系統中,一張表的銷量字段是 QTY,另一張表的數量字段是 XL。字段的業務含義、表與表之間的關聯關系,隻存在于開發人員的認知中;而這份“說明書”,是幾百萬行源代碼。
幾百萬行說明書,沒有人讀得完,AI 同樣讀不下去。為人而寫的内容,AI 都能讀;不為任何人而寫的,今天的 AI 都讀不懂。
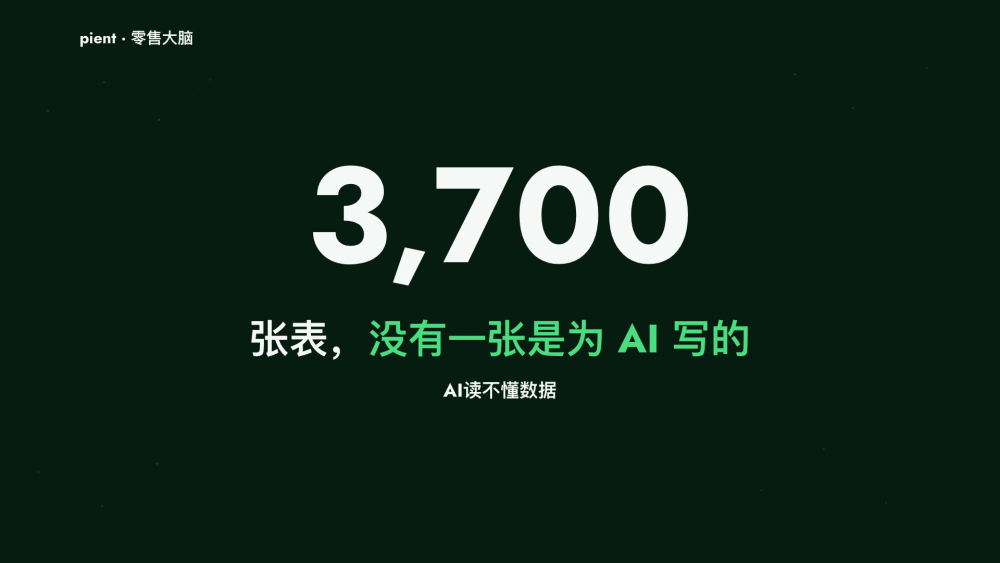
圖 2
讀不懂是第一個問題,敢不敢用是第二個。
AI 輸出錯誤的代價,在企業場景裡會被放大。導航給錯一條路線,損失隻是幾分鐘;但若 AI 把“下滑 20%”報成“增長 20%”,而企業已據此向工廠下了 20 萬元的訂單,代價就是真實的資金損失。更麻煩的是,AI 出錯時通常不會有任何報錯提示。
因此“可信”必須有明确定義:給出的數字,要能解釋清楚來源與構成;結論要能證明全過程;超出能力範圍時,要明确給出“不知道”。可解釋、可證明、會拒絕——這是企業敢用 AI 結論的前提。
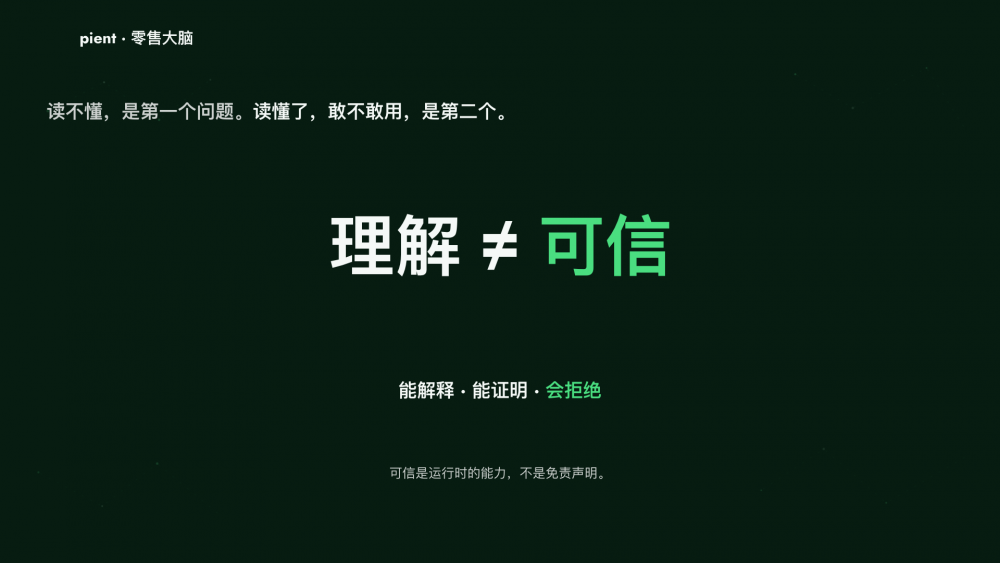
圖 3
二、産品定位:為“讀懂企業”而生的分析系統
這兩道門檻,行業裡繞了很久,始終沒能真正跨過去。
零售大腦(Retail Brain) 由此而生,由上海圓周率智能科技有限公司推出。它不是又一個“對話框”,而是一套面向企業經營的分析系統:直接接入企業自有數據庫,把“最近生意怎麼樣”“這筆合作能不能做”這類問題答上來,并且每一個數字都經得起追問。
能力邊界也不止于零售。企業的 CRM、供應鍊、會員、财務,任何一個系統都能接進來,不需要源碼,隻要數據庫,系統即可自動建模。建模完成後,既可以查詢這批貨的生産完成時間,也可以分析會員結構是否存在問題。
圖 4
三、核心能力:一本字典,一套憑證
零售大腦補上的,正是兩樣東西。
第一樣,是一本字典,叫本體論。 它源自亞裡士多德的哲學思想——用“實體”和“關系”這兩個最基本的元素,就可以描述整個世界。2006 年,Palantir 把它引入數據建模,如今已是企業服務市場裡市值數千億美元的公司。借助本體論,過去雜亂無章的 3.700 張表變得可讀:表之間如何關聯、每個字段什麼含義、每個數字對應什麼業務問題,都能給出明确答案。
第二樣,是一套憑證。 财務給出的數字之所以可信,是因為背後有完整的賬目與責任人。AI 給出的每一個數字,也應當具備同樣的可追溯性。
由此産生了“審計視圖”:綠色數字完全來自系統,藍色數字是計算得出的值,黑色數字尚未經過确認——黑色并不等于錯誤;指向其中任何一個數字,都能看到對應的來源憑證與唯一編号。
四、應用場景:十幾分鐘,走完一次經營問診
與零售大腦的對話,通常從一句最平常的話開始:“最近生意怎麼樣。” 沒有指定指标,也沒有指定報表,“最近”是多久、“生意”看什麼,全部由系統自行判斷。
系統選擇了最近 30 天:零售額約 144 萬元,同比下降 9.5%——随即補充了一個容易被忽略的口徑問題:老店的同店表現下滑幅度更大,7 家新店帶來的收入抵消了一部分下降,隻看整體 9.5%,會把老店的情況看輕。
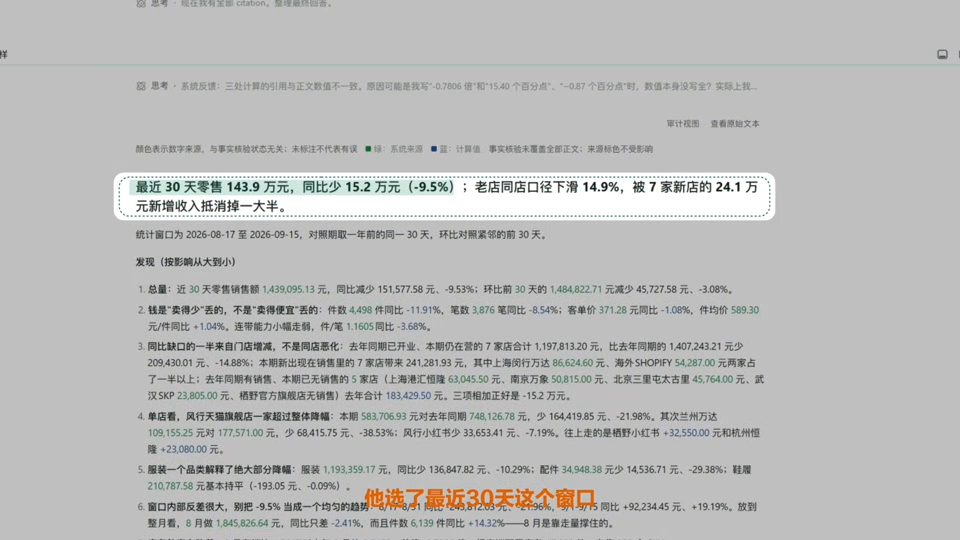
圖 5
繼續追問,得到的是一句歸因清晰的結論:“錢主要是賣得少丢的,不是賣得便宜丢的。” 件數與成交筆數下降,價格指标沒有明顯變化,因此排查方向應先指向銷量。若未區分這一點就貿然降價,很可能銷量問題尚未定位,價格已經降了下去。
對口徑的嚴謹,在門店對比中體現得更為明顯。對比兩家門店時,系統先糾正口徑:這屬于兩家具體門店之間的比較,而不是上海與深圳兩個城市市場的比較。它也排除了“新店爬坡”和“一家賣新貨、一家清老貨”兩種解釋;即便其中一家庫存明顯更少,也沒有直接得出“貨少所以賣得少”的結論,而是給出另一種可能——前期銷售不佳,導緻後期不敢補貨,庫存少的原因可能正好相反。
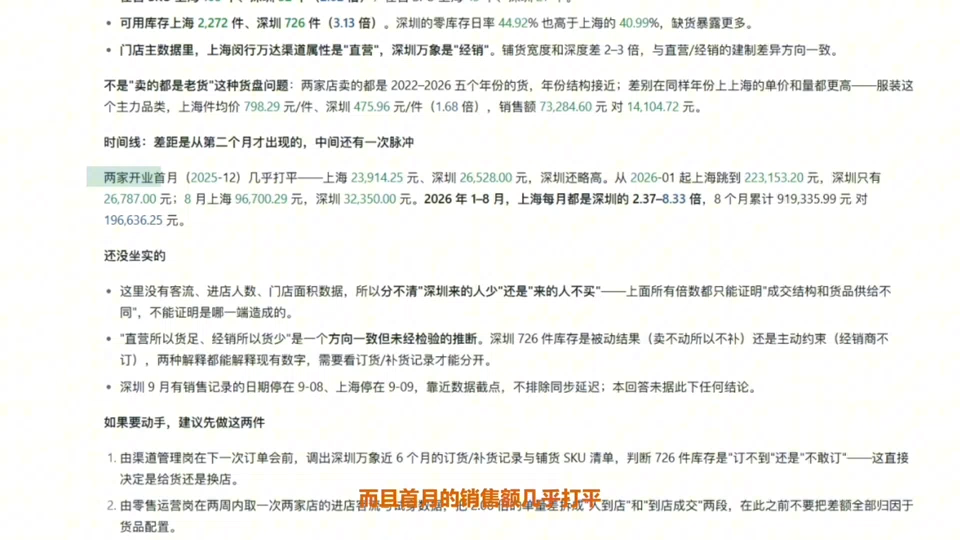
圖 6
系統的另一項能力是拒絕。詢問“每個導購壓了多少庫存”,它會先指出系統中不存在這個口徑——庫存挂在門店和 SKU 上,不歸屬于導購。詢問“看一下門店的毛利情況”,它會明确回答:毛利與成本類指标不在當前賬号的授權範圍内,這屬于權限拒絕,而非指标缺失;更換時間範圍、拆分門店分别查詢再彙總,同樣無法繞過。
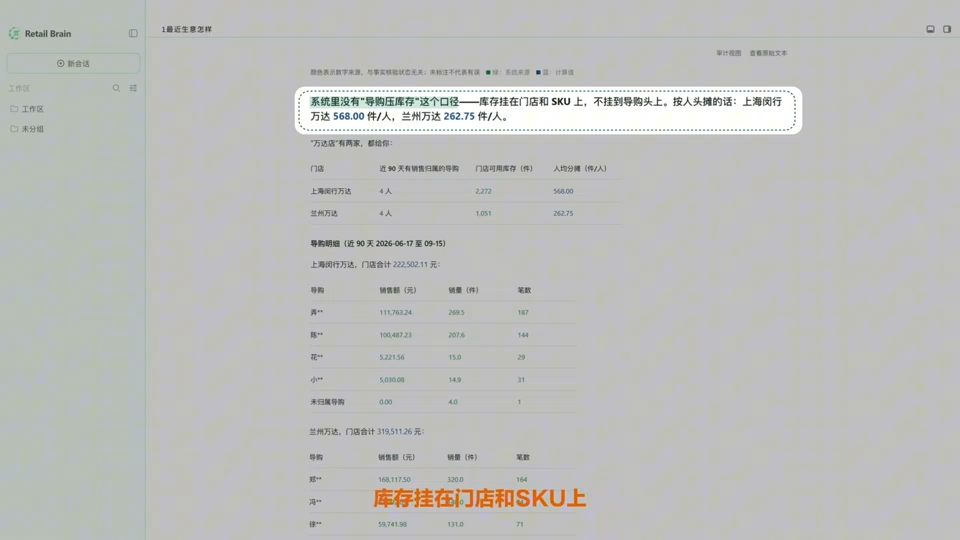
圖 7
當問題複雜度進一步上升,系統還有一個動作:立案——進入深度分析,相當于交出一個完整的調查項目。
第一個案子是常見的擴張誘惑:既然上海這家店比深圳賣得好,上海是否可以多開幾家?系統的結論是——現有證據不支持。這家店 1、2 月月銷均超過 20 萬,但 3 至 8 月月均隻有約 8 萬;以高峰月作為新店預算依據,計劃數字會很好看,而租金不會隻在高峰月發生。它給出的建議相對克制:若要嘗試,先做一家輕資産試點,補齊租金與客流數據,測算盈虧平衡月銷額,再與現有門店的常态水平對比。
第二個案子涉及真實投入:有加盟商願意承接杭州市場,前提是公司先在杭州開設一家旗艦店。系統首先識别出兩組數據不可混用——現有經銷客戶近 12 個月進貨額約 65.7 萬元,當地門店同期零售額約 72 萬元,前者是經銷進貨,後者是終端零售,都不能用于預測新店利潤。随後它點出真正的問題:新加盟商帶來的是增量生意,還是原有生意的轉移?并提示先在合作條款中明确兌現條件——避免門店裝修完成、租金已付,而對方未按量進貨。
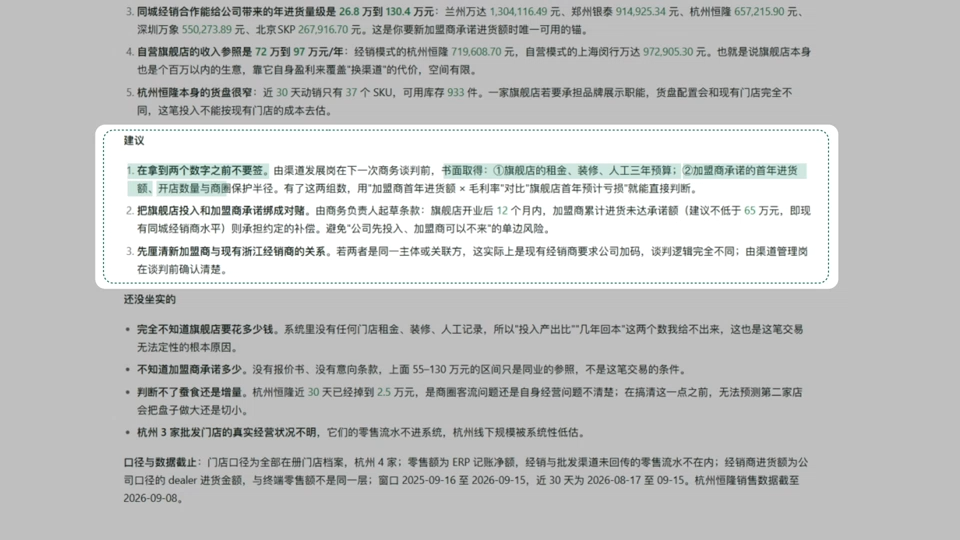
圖 8
十幾分鐘内,回答、下鑽、歸因、異常檢測與經營建議全部完成;一旦進入“立案”,系統還會先提出若幹假設,再逐條用數據驗證。
五、差異化優勢:為什麼不是 text to SQL
讓數據說話,這個行業做了 20 多年。從 BI 到數倉、數據中台,所有努力都指向同一件事,但至今沒有讓人滿意的答案。近幾年 AI 出現,整個行業集體走上了一條路徑:text to SQL——把一段文字生成 SQL,再到數據庫中取數。問題在于,當一句話需要關聯五張以上的表時,會産生“沉默出錯”:計算庫銷比時,銷量若忘記減退貨,數值即失真;以此推導一連串結論,而整段 SQL 語法完全正确,業務人員也很難立即發現問題。等到回查到那一小段錯誤時,經營決策窗口往往已經關閉。
零售大腦選擇的是另一條路徑。支撐它走通的原因有三個:一是既懂數據、更懂業務——業務即數據背後的來龍去脈;二是沒有技術包袱,發現路徑走不通即果斷切換;三是押注本體論足夠早,而 Harness 這一層技術恰好在卡住的時候給出了答案。
數據分析這條賽道上,Palantir、Snowflake、Databricks 等公司占據了最強位置。零售大腦沒有選擇正面競争,而是沿本體論路徑另開一局——目前這一路徑上還沒有第二家,但已經有兩三家在向這個方向靠近。
圖 9
六、落地與價值:隻讀接入,不動現有系統
當 10 年的經營數據接入後,每個數字出自同一口徑、每個結論都有憑證可查、每一次追問都能向下鑽取——過去月會上營銷、财務、營運報出三個不同數字、會後核實再無下文的問題,由此都有了明确結論。
成本方面,一組對比可以說明差距:過去回答“上海是否要多開幾家店”這類問題,需要引入外部顧問,經曆調研、取數、出報告的完整周期,費用動辄上百萬元;而現在,一次提問的成本約為一分錢。更重要的是不改造現有系統:隻讀接入、不動現有系統、數據不出域、可私有化部署——不需要押上現有架構,随時可以停止。
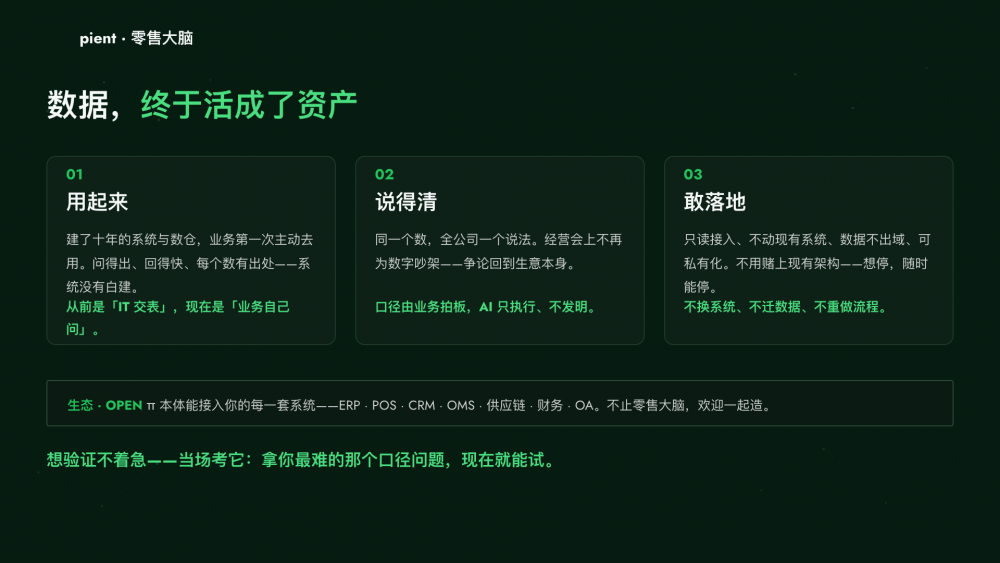
圖 10
七、結語:讓每個數字都有出處
回到開頭那個問題——“上個月銷量為什麼下滑?”
大模型答不了它,因為答案不在語言裡;BI、數倉、數據中台這幾十年做的事,也沒能給出答案,因為答案不在某一套報表裡。答案一直都在:在企業自己的數據庫中,在那 3.700 張表裡,隻是缺少一種把它讀懂的方式。
這幾年 AI 從“能聊天”走到“能幹活”,中間隔着的正是這兩道門檻——讀不懂,和讀懂了不敢用。零售大腦要做的,就是把它們拆掉:讓每個數字都有出處,讓每句結論都能被追問,也在超出能力範圍時,明确給出“不知道”。
讓 AI 讀懂你的企業——這件事,這個行業做了 20 多年,始終沒有一個讓人滿意的答案。現在,零售大腦給出了自己的答案。
關于圓周率
上海圓周率智能科技有限公司是伯俊科技旗下子公司,聚焦 AI 技術探索與産品研發。品牌名「pient」蘊藏雙重意涵:π 以無限不循環之姿,象征永無止境的求知與探索;ent 取自 entity(實體),呼應本體論從哲學追問存在本源,到 AI 領域定義實體關聯、構建知識框架的技術内核。公司使命:讓 AI 讀懂你的企業。
