自然語言直接糾偏:極智嘉具身智能将OOD任務成功率從5%提升至95%
/朝聞通/具身模型的感知、決策與操作能力正在快速提升。但進入真實物理世界後,卻仍可能因為未曾見過的物體位姿、環境擾動或長序列累積誤差而出現動作偏差,導緻分布外 (OOD) 任務成功率降低。
受端到端模型黑箱特性的長期制約,傳統方案通常隻能采用“重新采集示教數據,并對龐大的模型進行微調重訓”的糾偏方式。不僅時間與算力成本高昂,且難以解釋并根除失敗的深層機理。
極智嘉具身智能在 Gravity 框架下創新探索 Gravity Control 因果幹預模型,展現出業内領先的自然語言運行時糾偏能力:
無需訓練原始策略模型、無需新增示教數據,通過機制可解釋性挖掘模型内部的動作調控機制,并在推理階段直接幹預相關 latent feature,實現具身策略的運行時糾偏。
Gravity Control 從揭示端到端模型内部的因果表征機制入手,建立“概念可解釋+行為可控制”的雙向閉環。操作人員僅憑一句自然語言提示,便能精确激活與微調模型深層的運動特征,成功将分布外(OOD)複雜操作任務的成功率從17.5%大幅提升至87.5%,單項設置的成功率更是由5%飙升至 95%。
核心問題:“有概念”不等于“具因果”
要實現運行時糾偏,首先需要回答一個底層問題:模型内部大量 latent representations 中,哪些才真正擁有動作控制權?學界通常認為,如果一個神經元或表征能被解碼出某種語義概念,它就必定在指導機器人的行為。
但極智嘉具身智能研究發現,相關性不等于因果性(Not all concepts are causal)。
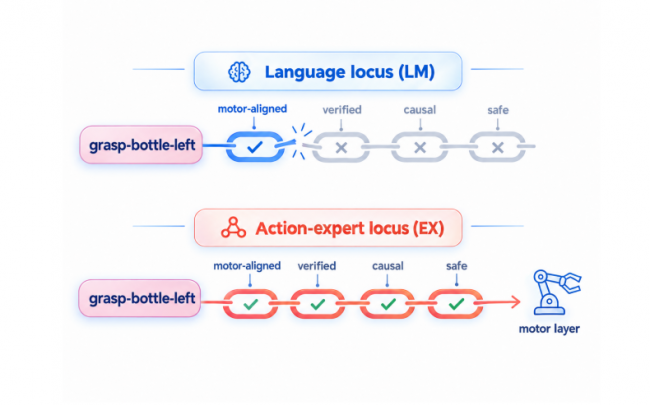
在大多數具身智能模型的骨幹網絡中,許多對特定物體或指令高度敏感的語言層表征,本質上隻是對文本Prompt或視覺場景的被動“語義描述”。而真正驅動末端執行器姿态、夾爪開合以及位移速度的“因果運動控制層(MotorLayer)”,高度集中在動作生成鍊路的動作專家(ActionExpert)深層。
為厘清内部表征的作用路徑,極智嘉研發團隊形式化定義了一條概念屬性鍊(Concept Property Chain),并依次驗證 Faithful 保真性 → Motor Aligned 運動對齊 → Verified 泛化驗證 →Causal 因果可控 → Safe 閉環安全。
實驗揭示,語言層特征往往在運動對齊或泛化驗證階段中斷。其特征名看似指向運動,實則無法幹預物理動作;唯有動作專家層能完整走通整條屬性鍊。
Gravity Control:找到模型内部真正可控的 Control Handles
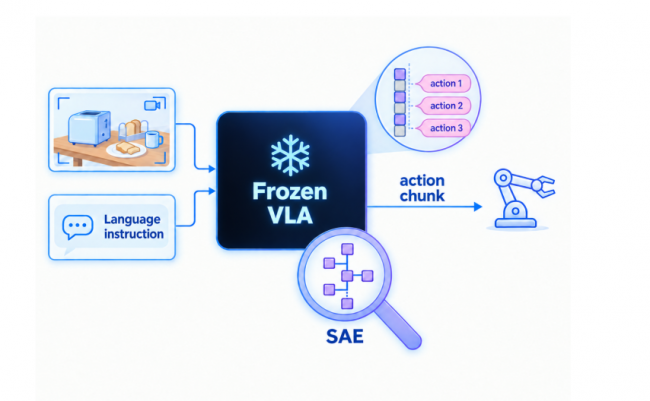
為系統分析模型内部的動作表征,極智嘉具身智能構建了 Gravity Control 模型:
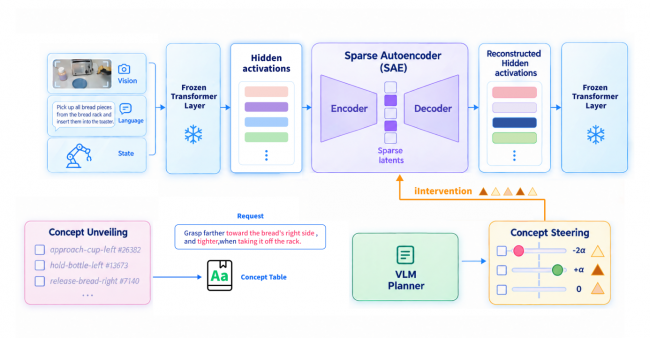
Gravity Control 模型框架總覽
首先,在凍結原始模型骨幹的前提下,Gravity Control 在 Residual Stream 中引入 Top-k SAE 等技術模塊,對高維 Hidden Activations 進行稀疏特征分解(Sparse Feature Discovery),從中提取具有可解釋語義的 latent features。
随後,通過定向因果幹預(Causal Intervention),對已完成語義标注的 latent feature 進行 amplification / suppression,并觀測位置、旋轉、夾爪等動作通道的響應。
為了驗證幹預是否隻作用于目标動作,而非同時擾動其他自由度,研究進一步引入幹預特異性評估(Specificity Ratio),篩選方向一緻、劑量響應單調、對目标動作影響較集中的Control Handle。
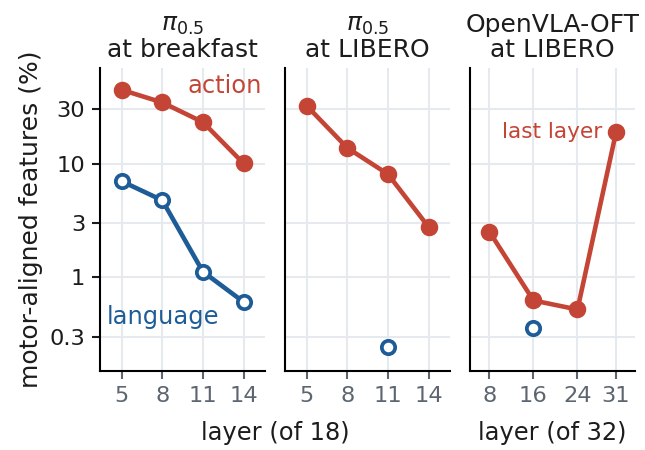
π0.5與OpenVLA-OFT在不同層插入SAE後得到的可用特征數量比例區别
相較于僅通過 feature activation 對模型内部進行“readout”,這一架構進一步建立了從Interpretability → Intervention → Control 的閉環。
以自然語言,直接糾偏底層動作
在完成 causal feature identification 之後,Gravity Control 進一步解決了一個更具工程意義的問題:如何讓人以自然語言方式調用這些底層 Control Handles?
傳統的端到端模型隻接受宏觀任務級指令(如“将面包放入盤中”),一旦執行過程遇到微小幾何偏差,上層語言指令無法傳遞精細的抓取深度、左臂手腕翻轉角、夾爪開度等底層控制參數。
基于已建立的概念控制表,Gravity Control 構建了語言引導的動作調節鍊路。
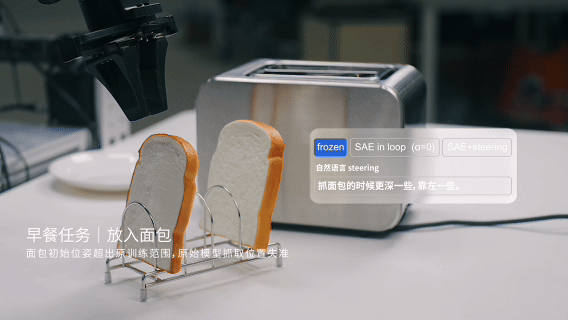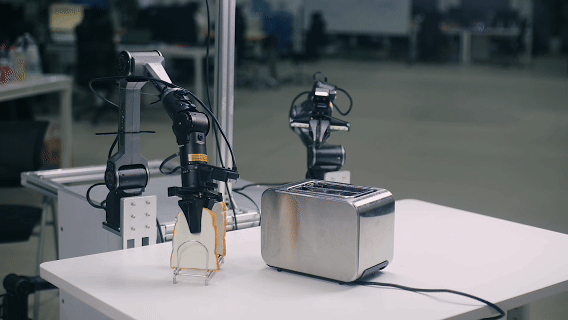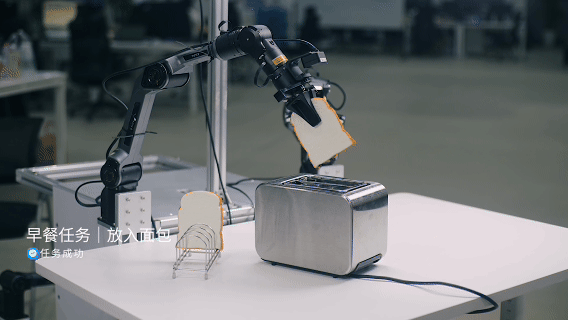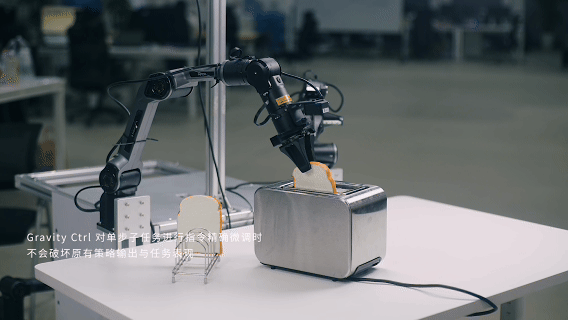
當機器人出現動作偏差,操作人員可發出自然語言提示(如“下夾取時抓得更深一點、更低一點”)。外部VLM規劃器無需重新規劃軌迹,而是檢索概念表中的特征詞表,對原始模型内部 activation 進行在線 steering。
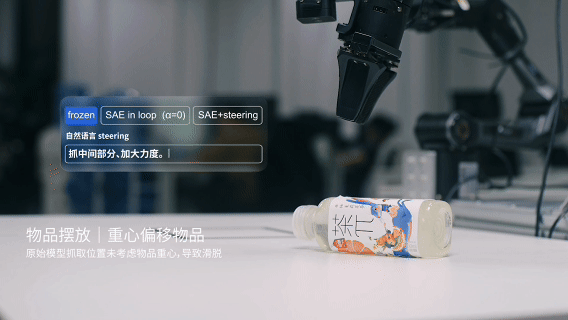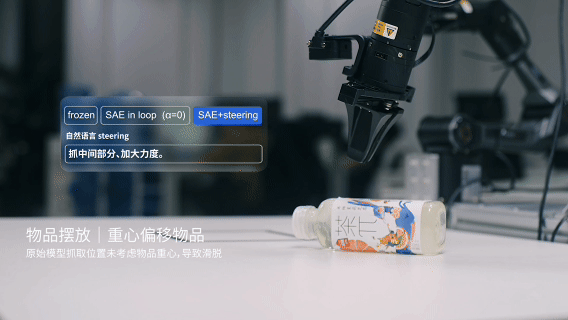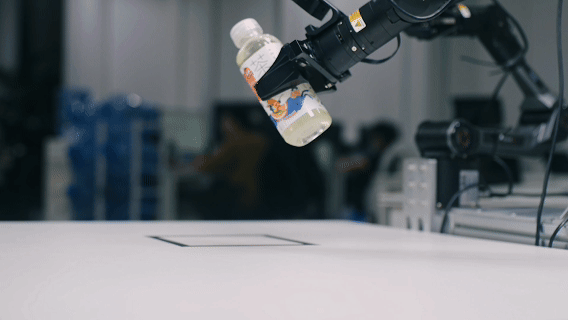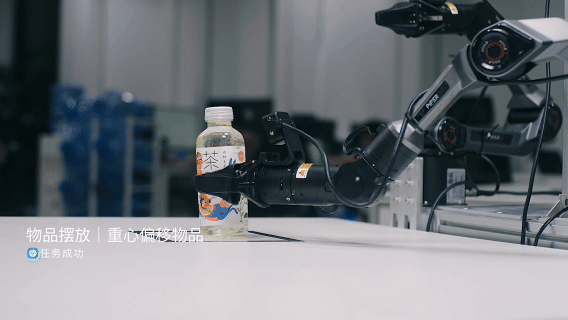
與重新規劃整條 trajectory 不同,這一路徑直接幹預模型内部已經學習到的 primitive motor representation。
同時,Closed-loop Gate 用于限制最大 intervention dose,确保幹預僅改變特定幾何自由度,而不引發災難性動作發散。
Gravity Control 的關鍵并不是“機器人聽懂一句話”,而是讓 correction intent 可以低成本地映射為模型内部可驗證、可約束的 runtime control。
實驗驗證:可解釋性與零微調OOD任務提升
Gravity Control 模型不綁定某一種具身策略架構,接入不同類型的原始模型均可實現以自然語言進行運行時糾偏,大幅提升OOD任務成功率。
當前,Gravity Control 模型已在 π0.5、OpenVLA-OFT 等代表性 VLA 架構、LIBERO simulation benchmark 以及物理機器人平台上進行了全面評估:
實驗首先驗證了 Naming 與 Control 之間的差異。彙總多個策略後,部分具有可靠語義名稱的 feature 最終并不能通過因果幹預測試;反之,能否真正成為 Control Handle,取決于 intervention 對 physical action 的實際影響,而非 feature 名稱本身。動作側可驗證、與運動對齊的特征也整體明顯多于語言側。
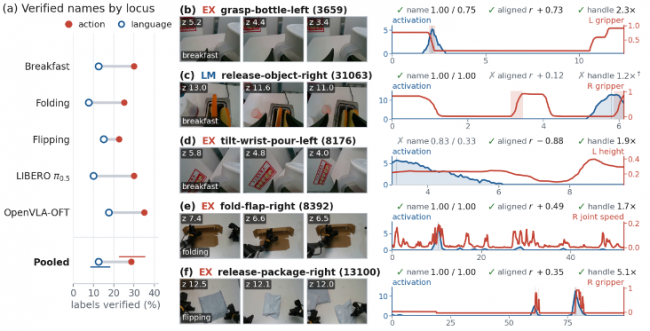
概念命名與動作因果控制相脫節 Naming and control come apart 現象
在真實機器人 OOD 任務中,在不更新原始策略模型權重、不新增機器人示教數據的前提下,該架構成功将橫放面包等分布外失敗任務的整體成功率從 17.5% 躍升至 87.5%,實現了即插即用的零樣本動作挽救。
其中,橫放面包這一單項 OOD setting 的成功率由5% 升至 95%。
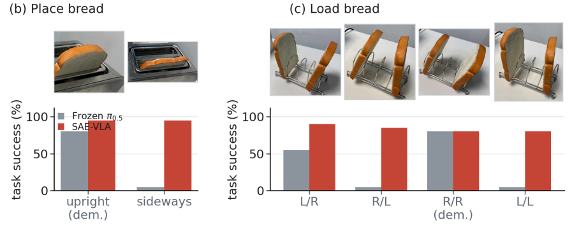
利用自然語言在線糾偏真實機器人的完整工作流
這表明 Gravity Control 的目标并非單純“把動作推向某個方向”,而是在 base policy 已具備基礎 任務能力的前提下,通過經驗證的 latent intervention 實現 zero-finetuning failure recovery,同時約束對原策略的副作用。
從 Correction 到 Skill:讓糾錯成為自進化的起點
随着各種端到端具身智能模型從 benchmark 逐漸進入真實物理環境,模型能力本身已不再是唯一需要關注的問題。更重要的是:當機器人出現失誤時,是否能夠診斷問題來自哪裡,并對局部行為進行可預測、可約束的幹預。
Gravity Control 可以進一步接入更上一級的 Agent 或 AI原生系統套件,由上層系統持續判斷任務狀态、識别動作是否偏離目标,并自動完成Detect → Diagnose → Correct的全流程作業鍊條。不必由人擔任機器人的“監督員”,而是由系統在局部錯誤進一步累積前,主動調用 Gravity Control。
更進一步,一次成功的 correction 也不必是一次性的。系統可以記錄當時的 task phase、scene / state、被調用的 Control Handle、intervention dose 與執行結果,将成功的糾偏過程沉澱為可複用的 Skill。下一次遇到相似狀态時,系統即可優先檢索并調用既有經驗,進一步降低對人工幹預的依賴。
這意味着 Gravity Control 的長期價值不僅是讓機器人“更容易被糾正”,而是讓一次糾錯逐步變成可以積累、複用的經驗。從 Correction 到 Skill 再到 Self-evolution,Gravity Control 為具身系統持續減少人工介入、走向自主糾錯與能力自進化提供新的技術路徑。
