不隻強在硬件!宇樹6B具身大腦拿下7項開源SOTA,對标GPT-6 Astra
/朝聞通/全球具身智能的競争,正從本體的比拼延伸到“大腦之戰”。
谷歌Gemini Robotics 2喊出“一個大腦,适用于任何機器人”,英偉達Jim Fan更是抛出“VLA已死,世界動作模型當立”。誰能成為具身智能的新一代通用模型底座?
國内,宇樹科技正在把這件事往前推一步。近日,宇樹新一代通用人形機器人基礎模型UnifoLM-WLA-1.0亮相,6B參數、約2500小時真機訓練,具身推理直接拿下7項開源SOTA,多項空間理解任務還反超GPT-6 Astra。同時,宇樹宣布将開放模型、代碼和數據集。
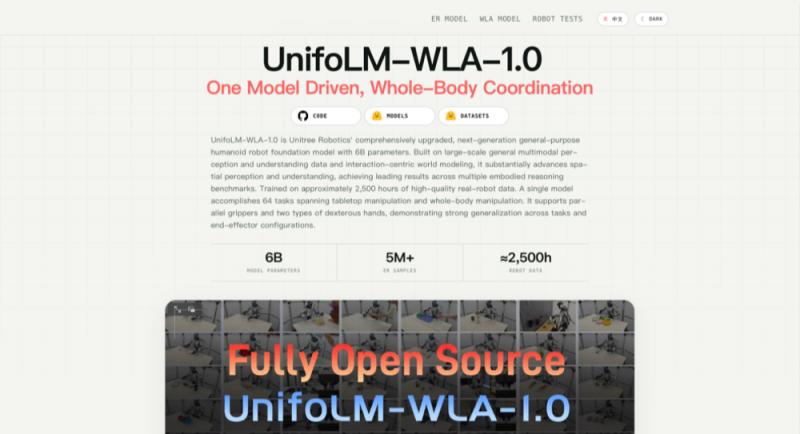
對于機器人而言,模型能力還是要落到真實任務中。人形機器人什麼時候能進入更多真實場景,實現“通用勞動力”?宇樹正在試圖回答這一靈魂一問。
UnifoLM-WLA-1.0單模型即可統籌64項任務,從疊毛巾、收納餐具,到鋪床、倒垃圾、把衣服放進洗衣機,驗證了其強大的模型泛化能力。
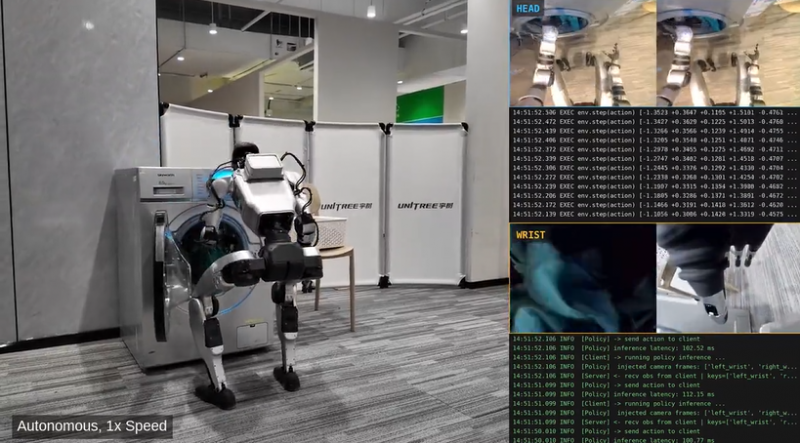
這背後藏着行業多年未解的老問題。過去的Demo多是單一任務、單一場景、高度定制,演示起來漂亮,換個環境就難複用,始終難以規模化。
而一套模型能否覆蓋更多任務、更多場景,恰恰是機器人走向通用的重要一步。宇樹此舉,正試圖讓國産廠商成為“具身智能大腦”的定義者。
01.拿下7項開源SOTA,比肩GPT-6 Astra:國産廠商搶“具身大腦”定義權
先看具身推理能力。UnifoLM-WLA-1.0的具身推理底座是UnifoLM-ER-1-4B。該模型基于Qwen3-VL-4B訓練,使用超過500萬條具身推理樣本,在16項多模态感知與理解基準中有7項領先表中參評的開源模型。
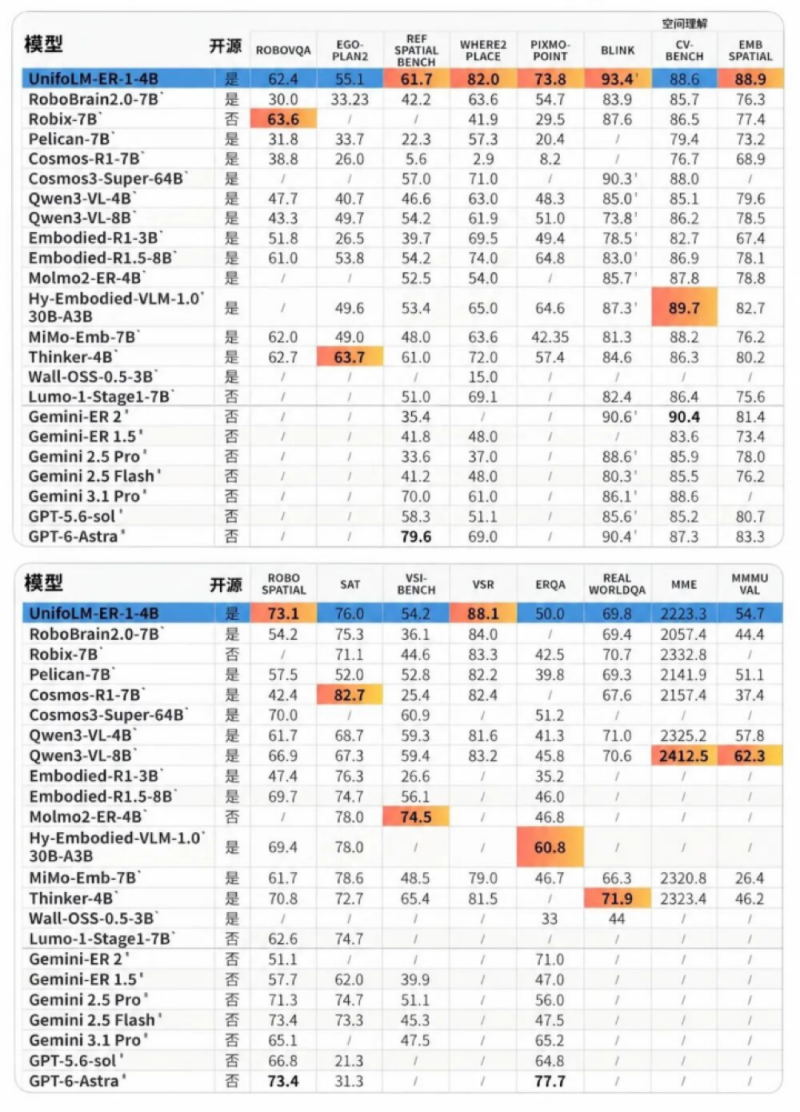
其中部分空間理解能力已經逼近甚至超過頭部閉源模型。
在Where2Place、BLINK、CV-Bench和EmbSpatial等基準中,UnifoLM-ER-1-4B的部分成績高于GPT-6 Astra。以Where2Place為例,UnifoLM-ER-1-4B得分82.0.GPT-6 Astra得分69.0;在EmbSpatial上,兩者分别得分88.9和83.3.
對機器人來說,空間理解比單純聊天能力關鍵得多。看得懂東西在哪、怎麼擺、下一步會發生什麼,才談得上做得對,也才具備走進真實世界的資格。
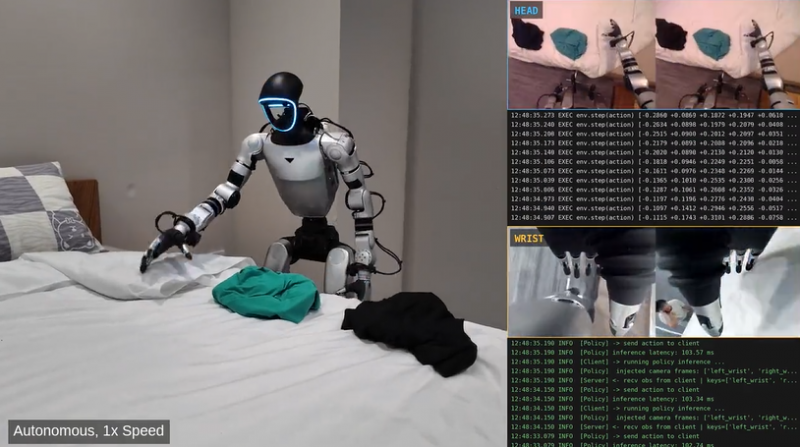
再看執行能力。UnifoLM-WLA-1.0把感知、推理、未來變化預測和動作生成連接起來,一個模型覆蓋64項任務,包括54項桌面操作和10項全身操作,并支持二指夾爪和多種五指靈巧手。
桌面側,它能疊衣服、收納餐具、給電池充電、整理鉛筆盒;
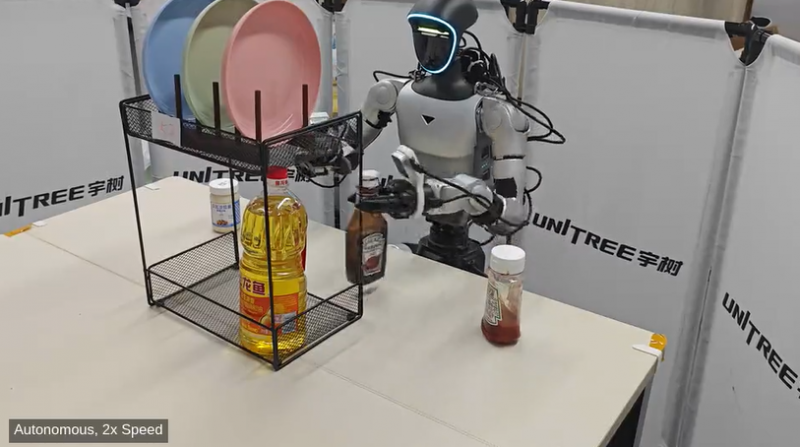
全身側,它會倒垃圾、鋪床、整理鞋、把文件夾放進櫃子。
把這些能力合起來看,宇樹正在嘗試把“具身智能大腦”概念變成一套可以在真機上驗證的模型體系。這家公司不再隻是本體強者,而是在搶開源生态話語權,對标“安卓之于手機”:底層能力保持開放,開發者圍繞其适配不同設備和場景,最終形成一個不斷擴大的生态。
02.先預測“哪裡變”,再生成“怎麼動”讓世界模型落到動作上
要取得這樣的成果并不容易。過去的VLA更像“看圖做動作”,看到物體、理解指令,再生成動作。但真實世界高度動态,一個動作往往會改變下一秒的環境,隻對眼前這一幀做判斷,往往不夠。
為此,宇樹把“具身推理+未來變化預測+動作學習”放進同一體系,讓機器人在動手之前,對動作可能帶來的變化形成判斷。
其中一個關鍵設計,就是把“哪裡會發生變化”單獨拿出來學習。宇樹首先利用光流,對機器人執行動作前後的畫面進行比較。
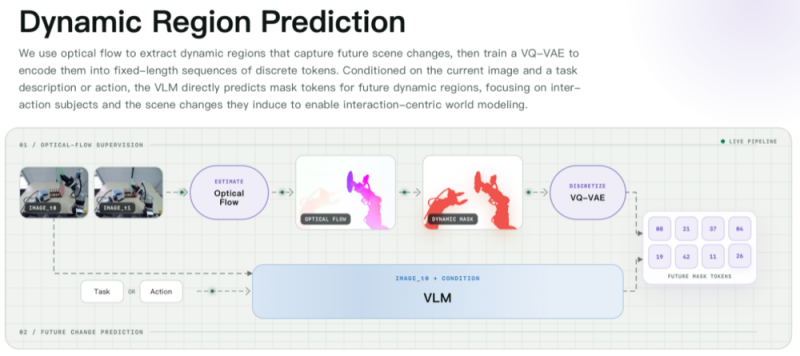
比如機械臂包裝手機時,背景裡的桌子基本沒有變化,真正發生明顯變化的是機械臂、手機以及兩者發生交互的區域。模型不需要把下一幀畫面的每個像素都重新預測一遍,而是把注意力集中到這些因為機器人交互而發生變化的區域。
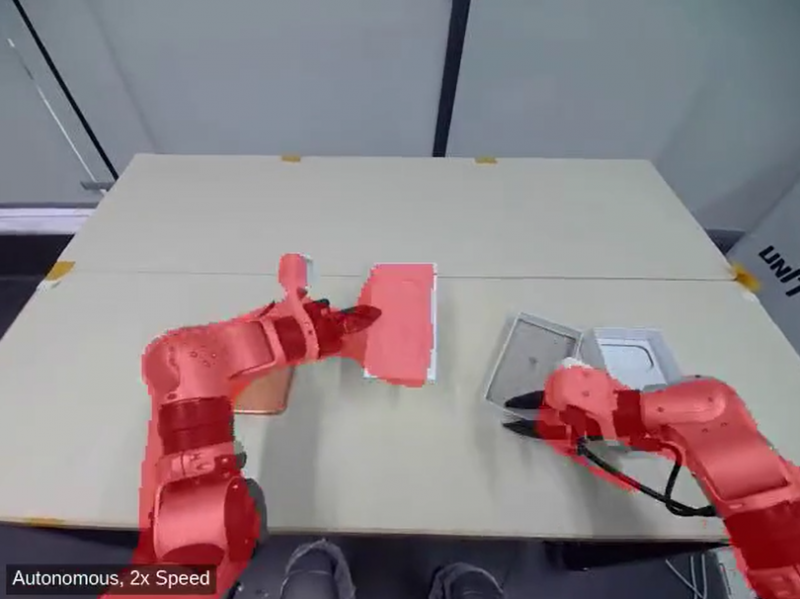
随後,這些變化區域被VQ-VAE壓縮成一串固定長度的離散Token。僅需給定當前畫面和任務描述(或将要執行的動作),模型就能直接預測出下一步哪些區域會變。宇樹将其稱為以交互為中心的世界建模(interaction-centric world modeling)。
有了對未來變化的預測,下一步則是把這種理解真正接到機器人的動作上。
但機器人動作本身又比一句自然語言複雜得多。以人形機器人為例,一次看似簡單的“整理沙發抱枕”,就同時涉及手臂末端往哪裡移動、夾爪或者靈巧手如何開合,以及下半身如何配合調整姿态。
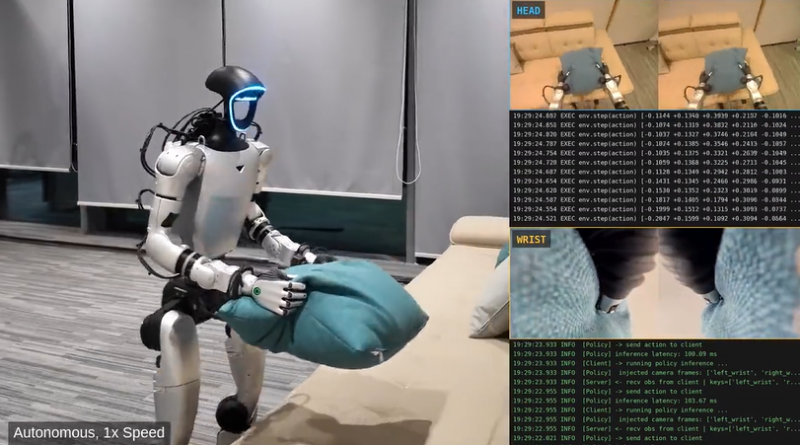
如果把所有動作簡單塞進一個連續空間裡學習,不同身體部位之間的動作表達會非常複雜。
宇樹幹脆把統一動作空間拆成三路:末端執行器位姿、末端執行器關節、下肢關節,各自用RVQ離散成Token。
原本連續變化的運動軌迹,被翻譯成一套“動作語言”,機械臂怎麼走、手怎麼動、下半身怎麼配合,都有對應的Token,還按同一條時間軸同步輸入。
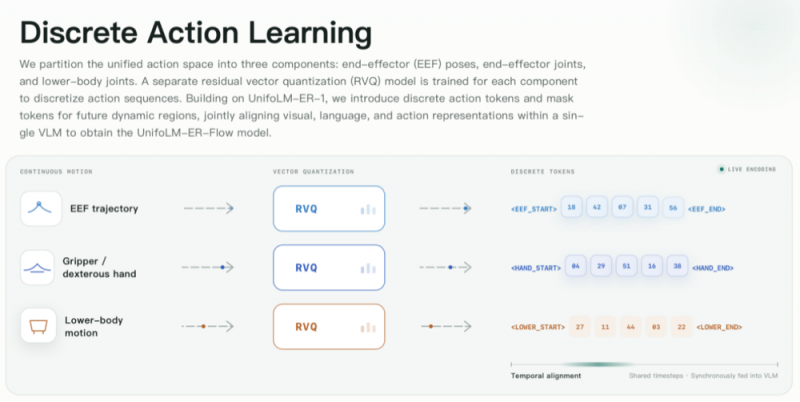
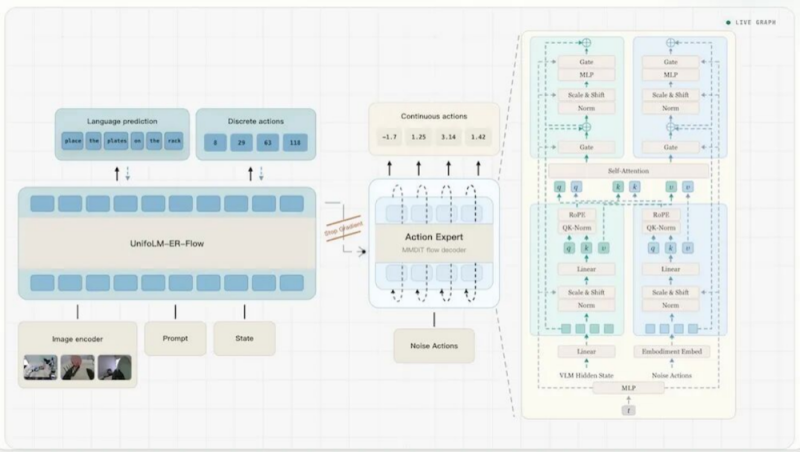
在UnifoLM-ER-1的基礎上,宇樹進一步把這些動作Token和前面的未來動态區域Token,與圖像、文字放進同一套表示空間,形成UnifoLM-ER-Flow。到這裡,模型既理解當前看到的世界,也能預測一次交互會讓哪裡變,還知道該采取什麼動作。
但這離真正控制機器人,還差最後一步:離散Token适合模型理解和推理,真實機器人最終執行的卻是連續動作。
于是到了UnifoLM-WLA-1.0.宇樹在UnifoLM-ER-Flow上加入MMDiT Action Expert,把模型對任務、未來變化和動作的理解,進一步解碼成機器人能真正執行的連續動作。
至此,一條完整鍊路形成了:機器人先預測哪裡會變,再生成怎麼動。
世界模型由此參與動作生成,使人形機器人能夠把環境理解、變化預測和全身控制連接起來。
03.2500小時真機數據背後:模型是公開牌,數據與場景是護城河
模型參數可以公開,真正難複制的是持續産生高質量機器人數據的能力。具身模型最大的門檻之一,是數據來自真實世界。
原因在于,圖文數據可以按億為單位從互聯網上抓取,真機數據卻隻能讓真實的機器人跑出來。2500小時高質量真機數據,相當于一台機器人連續采集超過100天,而且每一幀都要真實、有效、能拿來訓練。
UnifoLM-WLA-1.0使用約2500小時真機數據訓練,數據覆蓋不同的機器人本體和作業場景。
超過500萬條具身推理樣本覆蓋圖像點預測、物體檢測、多圖推理、2D軌迹預測、3D物體檢測和多圖空間問答,并與通用圖文數據共同訓練;約2500小時真機數據則用于WLA模型訓練。兩類數據對應不同訓練階段。
真機數據既需要時間,也需要成規模的機器人産能。對隻做模型的玩家來說,光是把機器人鋪開去采數據,就是一筆繞不開的硬投入。
而另一大技術壁壘則是統一模型。
其把視覺、語言、動态區域Token和動作Token放進同一個多模态模型,再加入MMDiT Action Expert生成連續機器人動作,走出“多本體+統一動作空間”的路線,讓不同身體部位在同一時間步協同學習。
所以,模型是公開牌,背後真機數據與持續産數據能力才是底牌。
數據決定模型能否持續覆蓋更多任務和場景。随着權重、代碼和數據逐步開放,開發者可以在64項任務之外繼續檢驗模型的泛化邊界,并開展二次開發和場景适配。
這也意味着,宇樹提供的正在從一台機器人,延伸到一套可以被反複調用、适配不同任務的具身智能底座。對行業客戶而言,這樣的底座一旦能夠被更多機器人、場景和開發者複用,其價值就不再局限于單一硬件,而會進一步延伸到行業解決方案和平台化能力。
換句話說,開源“大腦”并沒有削弱宇樹的護城河,反而讓它進一步落到真機數據、真實場景和持續疊代能力上,再通過開放模型吸引更多開發者和生态夥伴加入。
這條路跑通後,宇樹拿得出來的,是一套能持續進化、還能帶着生态一起走的底座。宇樹的前途,也由此越走越寬。
04結語:從定義身體到定義大腦具身智能進入“生态卡位戰”
從四足到人形,宇樹過去一直以本體和運動能力被行業記住。如今,宇樹兩條腿走路,恰好踩在具身智能競争的分水嶺上:拼硬件的競争還在加碼,拼大腦、拼生态的階段也正在展開。
當模型參數和代碼都能公開,真正稀缺的是持續産出高質量真機數據的能力,以及圍繞這套體系聚集起來的開發者生态。
如今,具身智能的“安卓時刻”,或許正在由國産廠商拉開帷幕。(智東西)
